Wie wichtig ist die Datenbasis bei KI wirklich?
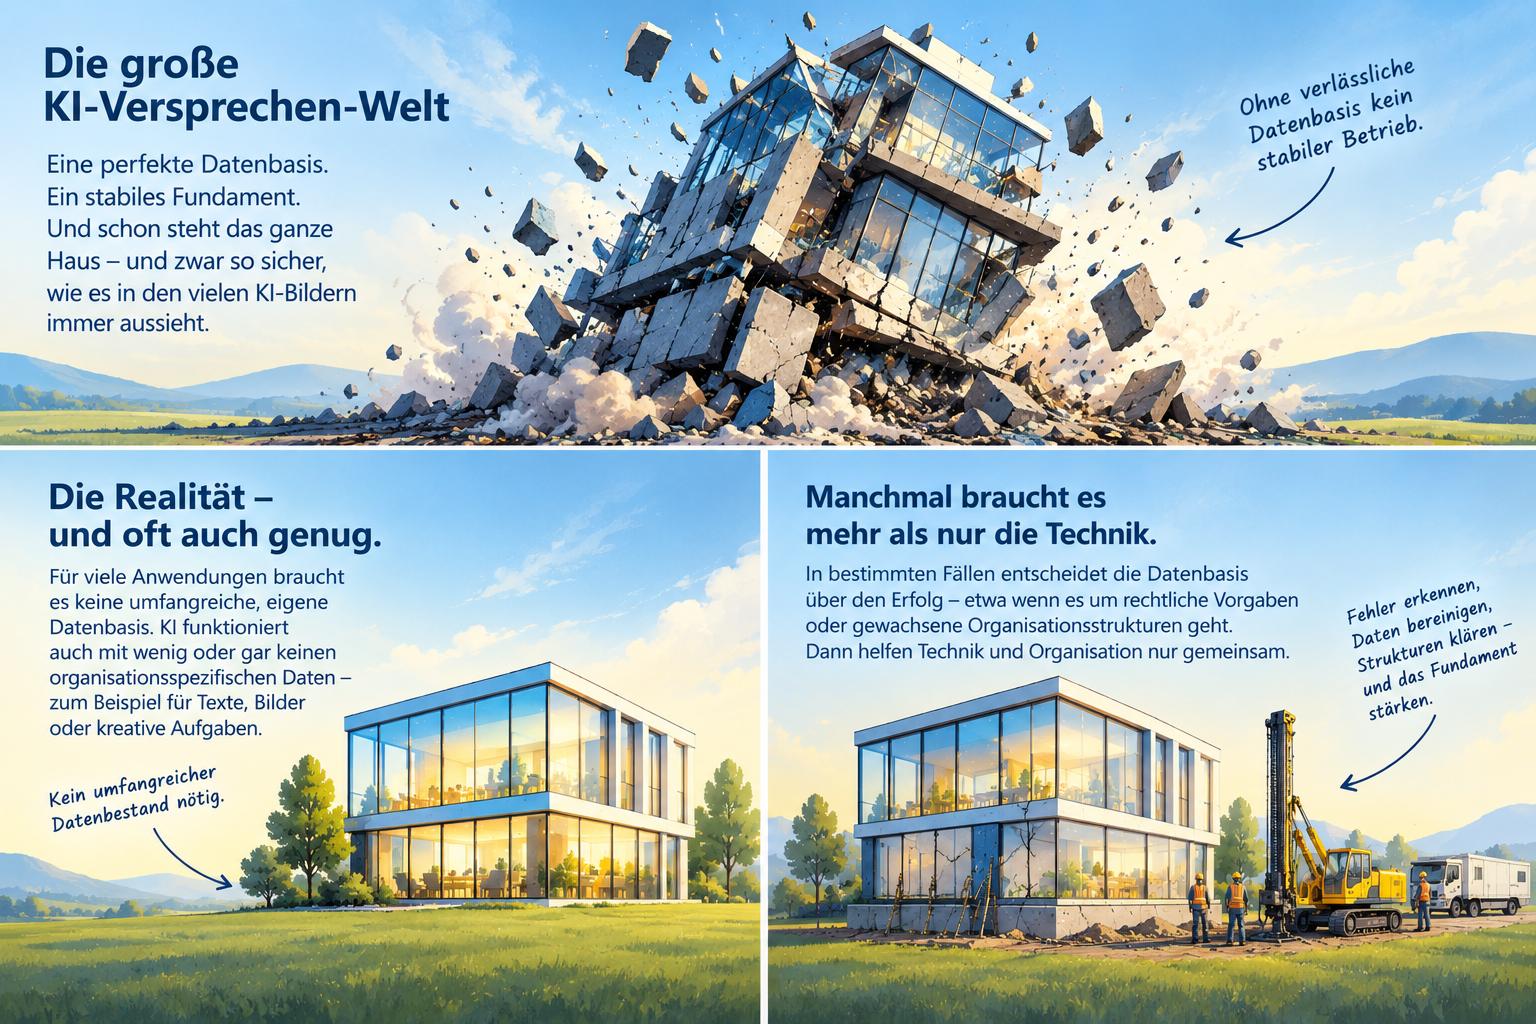
Kaum ein Bild wird bei LinkedIn und in Vorträgen zu KI so häufig bemüht wie das vom Fundament. Die Datenbasis als Grundstein, ohne den das ganze Haus einstürzt. Das Bild ist eingängig, aber als allgemeine Aussage schlicht falsch. KI funktioniert in vielen Anwendungen hervorragend, ohne dass irgendeine umfangreiche Datenbasis nötig wäre. Wer ein Sitzungsprotokoll erstellen lässt, wer eine Marketingkampagne entwerfen will oder wer sich für ein Bild am Stil der eigenen Homepage orientiert, kommt oft mit sehr wenig oder gar keiner eigenen Datengrundlage aus. Wichtig ist dabei die Unterscheidung zwischen dem allgemeinen Informationsbedarf einer solchen Aufgabe und einer eigenen, organisationsbezogenen Datenbasis, die vorab aufgebaut und gepflegt werden muss. Ein Sprachmodell arbeitet immer mit Daten, mit denen es trainiert wurde. Für die genannten Aufgaben muss eine Organisation aber keine eigene Wissensbasis vorhalten, bevor sie loslegen kann.
Es kommt auf den Kontext an, und genau das geht in der Fundament-Metapher unter. Es gibt aber Anwendungsfälle, in denen die eigene Datenbasis tatsächlich über Erfolg oder Scheitern eines Projekts entscheidet, und zwar dort, wo die KI tiefe Einblicke ins geltende Recht oder in gewachsene organisatorische Strukturen braucht, um überhaupt zuverlässige Antworten geben zu können. Zwei Beispiele zeigen, wie teuer es werden kann, wenn genau diese Voraussetzung übersehen wird.
In einer Universität zeigte sich das besonders deutlich. Die Hochschule wollte die Beratung zur Immatrikulation KI-gestützt anbieten. Studieninteressierte sollten auf der Webseite direkt Antworten zu Zulassungsvoraussetzungen und Studieninhalten bekommen, ohne den Umweg über Broschüren oder Wartezeiten in der Studienberatung. Die Idee war naheliegend und die technische Umsetzung überschaubar.
Das Problem lag woanders. Das System wurde mit dem gesamten vorhandenen Datenbestand der Universität gefüttert, und darunter befanden sich auch alte Prüfungsordnungen, überholte Zulassungsregelungen und Verordnungen, die längst durch neuere Fassungen ersetzt worden waren. Für einen Menschen, der mit der Struktur dieser Dokumente vertraut ist, wäre das kein großes Problem gewesen. Für die KI war es eines, und zwar ein erhebliches. Überschriften variierten zwischen alten und neuen Fassungen. Aktuelle Regelungen standen zudem teilweise an völlig anderer Stelle im Datenbestand als die Vorgängerregelung, die sie ersetzt hatten, und ohne verlässliche Kennzeichnung, welche Fassung galt, konnte das System nicht zuverlässig unterscheiden, was noch anzuwenden war und was nicht.
Am Ende musste die Universität den gesamten Datensatz nachträglich bereinigen, veraltete Fassungen aussortieren und aktuelle Regelungen eindeutig kennzeichnen. Dieser Aufwand hat nach Angaben der Beteiligten ein Vielfaches der Zeit und der Ressourcen gekostet, die für das Aufsetzen des KI-Systems selbst nötig waren. Die Technik war der einfache Teil des Projekts.
In einem Klinikum zeigte sich eine ähnliche Konstellation. Es wollte allgemeine Patientenfragen zu Aufnahmeverfahren und Kostenübernahme KI-gestützt beantworten, um das Personal an der Aufnahme zu entlasten. Die Datengrundlage dafür bestand aus Formularen und Merkblättern, die über Jahre hinweg in unterschiedlichen Abteilungen unabhängig voneinander gepflegt und aktualisiert worden waren. Für dieselbe Fragestellung, etwa zur Kostenübernahme bei bestimmten Behandlungen, lagen dadurch mehrere Versionen im System, die sich in Details unterschieden und nicht mehr deckungsgleich waren. Welche davon die tatsächlich gültige war, ließ sich aus dem Datenbestand allein nicht erkennen, weil keine der Abteilungen wusste, dass an anderer Stelle im Haus eine eigene, abweichende Fassung existierte.
Entscheidend bei beiden Fällen war weniger die Größe der Datenmenge als ihre Widersprüchlichkeit über die Zeit hinweg. Beide Organisationen hatten über Jahre hinweg Dokumente angesammelt, ohne sie auszusortieren, zu kategorisieren oder eindeutig als aktuell oder überholt zu kennzeichnen. Im Kern geht es dabei um Daten-Governance, also um Aktualität, Versionierung, Zuständigkeit, Gültigkeit und Widerspruchsfreiheit der eigenen Bestände, nicht um deren schiere Menge. Wo genau dieser Zustand herrscht, reicht es nicht, ein KI-System aufzusetzen und mit dem vorhandenen Bestand zu füttern. Wo eine Aufgabe dagegen wenig oder keinen Rückgriff auf gewachsene, möglicherweise widersprüchliche Bestände braucht, spielt die eigene Datenbasis diese Rolle gar nicht erst.
Die Datenbasis ist allerdings nur eine der Voraussetzungen. Selbst eine saubere Datenbasis verhindert nicht, dass ein KI-Projekt an anderen Stellen scheitert.
Häufig bleibt während des Projekts unklar, wer am Ende inhaltlich verantwortet, was das System ausgibt, die IT-Abteilung, die Fachabteilung oder die Rechtsabteilung. Dahinter steckt eine Governance-Frage, die über die reine technische Zuständigkeit hinausgeht, nämlich wer die inhaltliche Verlässlichkeit des Systems verantwortet. Gerade bei rechtlich geprägten Auskünften ist diese Frage entscheidend, und ohne ihre Klärung bleibt niemand zuständig, bis ein konkreter Schadensfall sie erzwingt.
Viele Projekte scheitern zudem an der internen Erwartungshaltung. Intern wird oft eine Fehlertoleranz von null erwartet, die kein System dieser Art leisten kann. Interessanter als die bloße Feststellung, dass KI Fehler macht, ist dabei die Differenz zwischen technischer Fehlerquote und organisatorischer Fehlertoleranz. Ein System kann eine hervorragende Trefferquote haben und trotzdem organisatorisch ungeeignet sein, wenn niemand weiß, wie mit den wenigen verbleibenden Fehlern umzugehen ist. Nach dem ersten sichtbaren Fehler kippt das Vertrauen dann vollständig, und das Projekt wird eingestellt, obwohl die Fehlerquote insgesamt vertretbar gewesen wäre.
Drittens fehlt oft ein Rückkanal für Nutzerrückmeldungen. Wird das System live geschaltet, ohne dass Nutzer einfach markieren können, wenn eine Antwort falsch oder veraltet war, bleiben genau die Fehler unentdeckt, die aus einer unsauberen Datenbasis stammen. Der Rückkanal ist dabei mehr als reine Fehlerkorrektur, er ist selbst Teil der Daten-Governance. Ein unsauberer Datenbestand führt zu Fehlern in der KI-Nutzung, Nutzer melden diese Fehler zurück, die Meldungen führen zur Bereinigung des Bestands, und die bereinigten Daten verbessern wiederum die Qualität der KI. Ohne diesen Kreislauf erodiert das Vertrauen schleichend, statt an einem klaren Punkt korrigiert zu werden.
Am Ende zeigt sich, dass die Menge der Daten selten das eigentliche Problem ist. Entscheidend ist, ob eine Organisation weiß, welche Informationen gelten, wer dafür verantwortlich ist und wie Fehler wieder zurück in den Bestand gelangen.